

文|Alpha说 南希
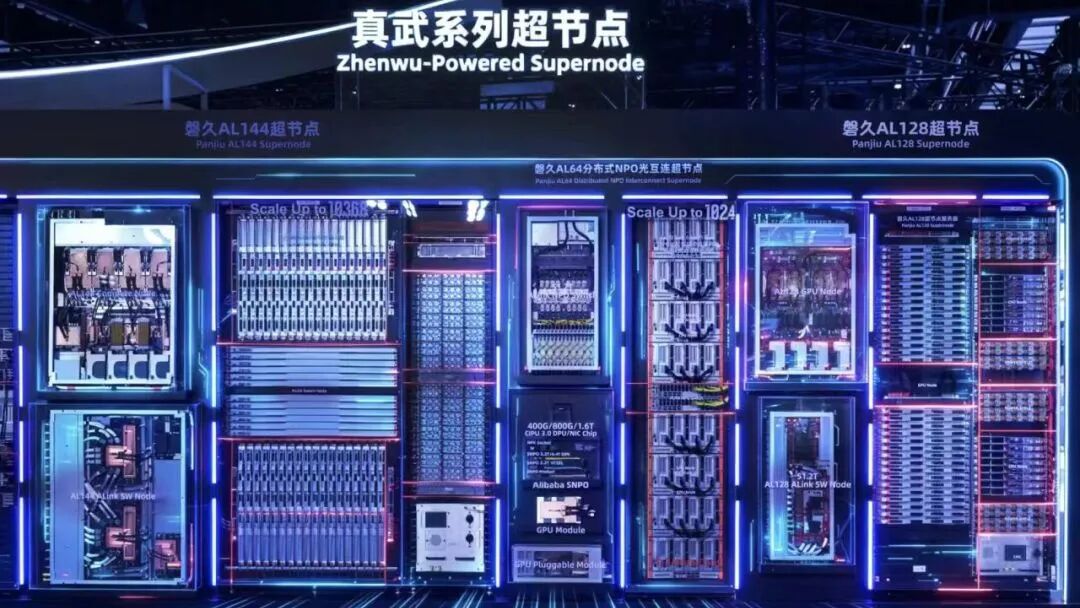
五天时间里,华为、浪潮、阿里相继把新一代超节点推到台前。
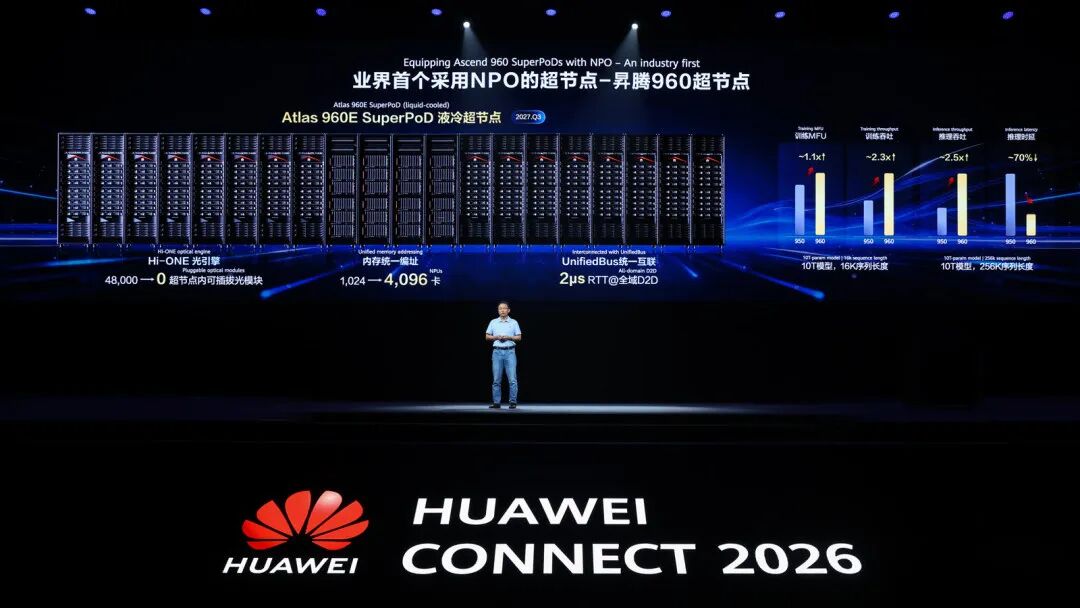
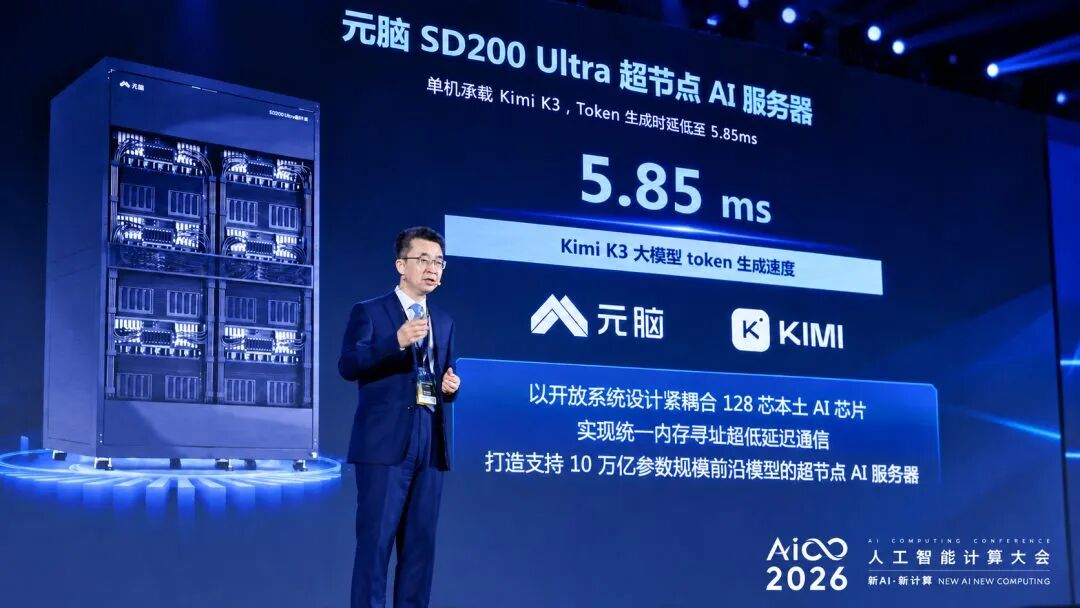
华为发布昇腾960超节点,将4096张算力卡纳入统一计算系统;浪潮发布元脑SD200 Ultra,以3D Hyper Mesh架构紧耦合128颗本土AI芯片;阿里则围绕真武V900、ICN互联芯片、磐脉智能网卡和镇岳SSD主控芯片,升级新一代磐久超节点。
三家公司采用的技术路线并不完全相同,却在解决同一个问题:
当一颗芯片已经无法独立承载不断扩大的模型,如何让更多芯片、内存和网络像一台计算机一样工作?
超节点的集中升级说明,AI算力的竞争单位正在发生变化。过去行业首先比较一张卡有多少算力、多少显存;现在,芯片之间能否高效协同,开始决定整个系统最终能够提供多少有效算力。
超节点的真正变化,不只是把更多算力卡放进同一套系统,而是让芯片、互连、内存、供电、散热和软件共同决定最终能够释放多少算力。
01 算力的瓶颈,正在从计算延伸到“搬运”
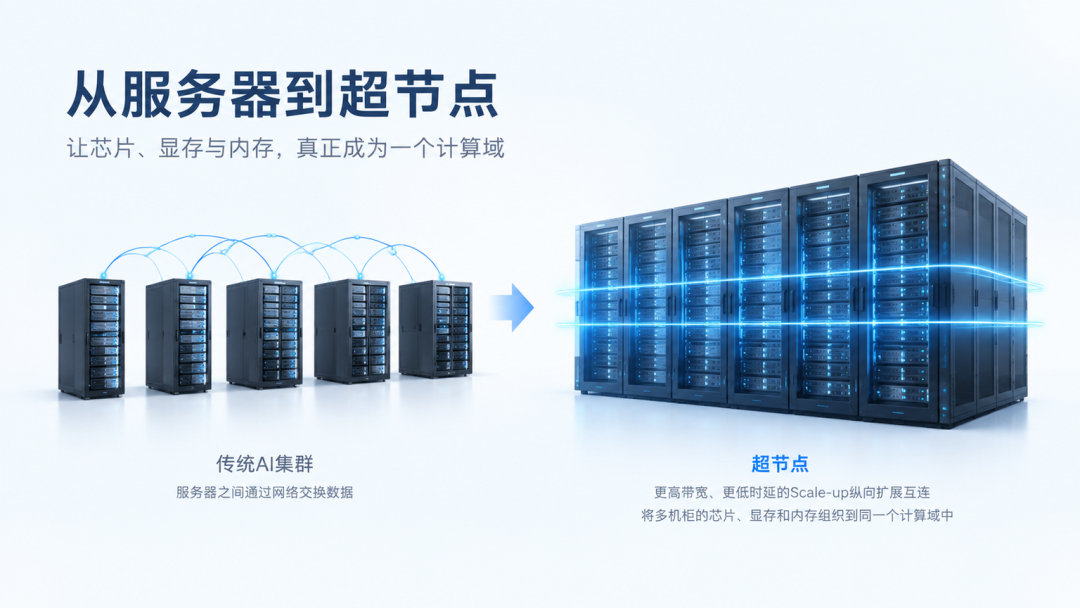
传统AI集群通常由一台台服务器组成。每台服务器内部的芯片连接紧密,服务器之间则通过网络交换数据。
模型规模较小时,这种方式能够满足需要。但随着大模型走向MoE、长上下文和Agent,计算系统承受的压力开始从单纯计算延伸到通信、内存和稳定性。
MoE模型需要不断把任务分配给不同专家,对芯片之间的通信效率提出更高要求;长上下文会产生大量KV Cache,持续占用显存和内存带宽;Agent完成一项复杂任务,可能经历数百轮推理、工具调用、反馈和重新规划,进一步放大系统时延和稳定性问题。
如果数据移动速度跟不上,算力再高的芯片也会等待。
这就像一家工厂拥有大量高速设备,但物料在不同车间之间传递得太慢。设备的峰值产能很高,整条生产线的实际产出却上不去。
超节点要做的,是扩大芯片之间的“高速协作区”。
它通过更高带宽、更低时延的Scale-up纵向扩展互连,把原本分布在不同服务器里的芯片、显存和内存组织到同一个计算域中。对于上层模型来说,这些物理上分散的设备,逻辑上更接近一台拥有巨大算力和内存的计算机。
因此,超节点的核心并不只是放入更多算力卡。真正发生变化的是:计算系统的边界从服务器扩大到了机柜,甚至跨越多个机柜。
02 三条技术路线,指向同一个目标
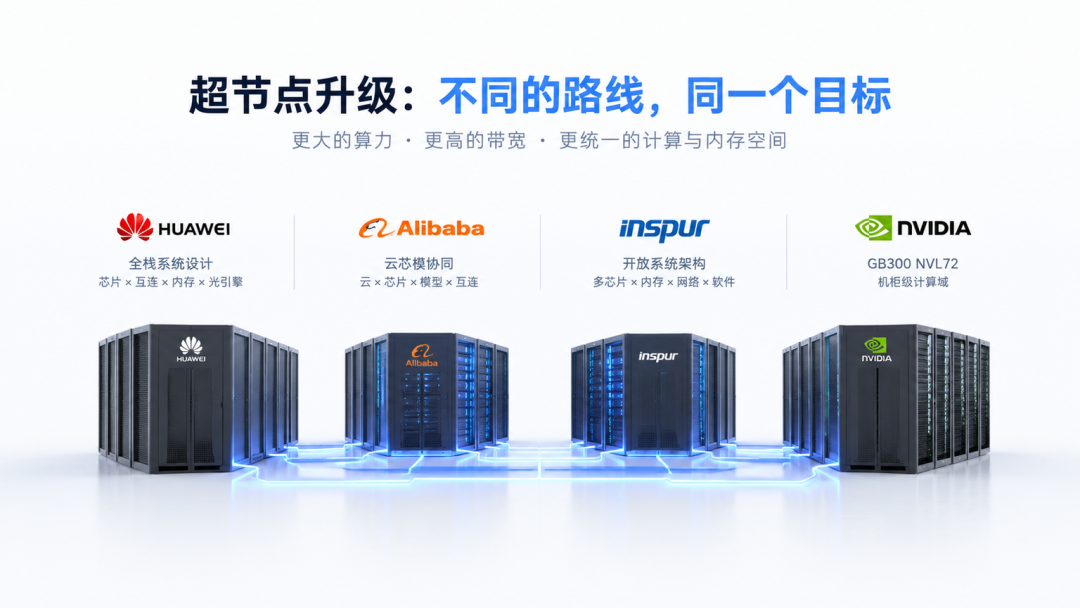
在这轮超节点升级中,华为、阿里和浪潮呈现出了不同的实现路径。
华为将灵衢UnifiedBus、统一内存编址和Hi-ONE NPO光引擎放入同一套系统设计。昇腾960超节点可扩展至4096卡,并通过NPO解决大规模互连中的带宽、距离和功耗问题。
阿里的路径更强调云、芯片和模型之间的联合设计。新一代磐久超节点将真武AI芯片、ICN互联芯片、智能网卡和SSD主控芯片纳入同一系统;SNPO则进一步探索面向Scale-up场景的光互连。
浪潮SD200 Ultra采用3D Hyper Mesh架构,将128颗本土AI芯片紧密连接,并通过统一编址和对称内存,让芯片能够直接访问远端显存。它在超节点内部继续使用短距铜互连,强调低时延和可靠性。
三条路线的差异,不只在于使用铜互连还是光互连,也在于谁来定义这套系统。华为从芯片和互连协议向上构建全栈,阿里从云端模型负载向下定义基础设施,浪潮则通过开放系统把不同芯片、内存、网络和软件组织成可交付的算力平台。
作为全球参照,英伟达的GB300 NVL72同样沿着这一方向演进:72颗GPU通过NVLink组成一个机柜级计算域,整套机柜成为交付和扩展的基本单元。
这些路线说明,铜互连和光互连会根据距离、带宽密度、功耗与可靠性形成新的分工。短距离连接仍然可以使用铜;随着计算域向跨柜和更大规模扩展,光开始进入过去由电连接主导的Scale-up网络。
路线可以不同,目标高度一致:减少芯片之间的数据搬运和协议转换,扩大能够被统一调用的高速计算与内存空间。
03 超节点把整个产业链重新装进一台机器
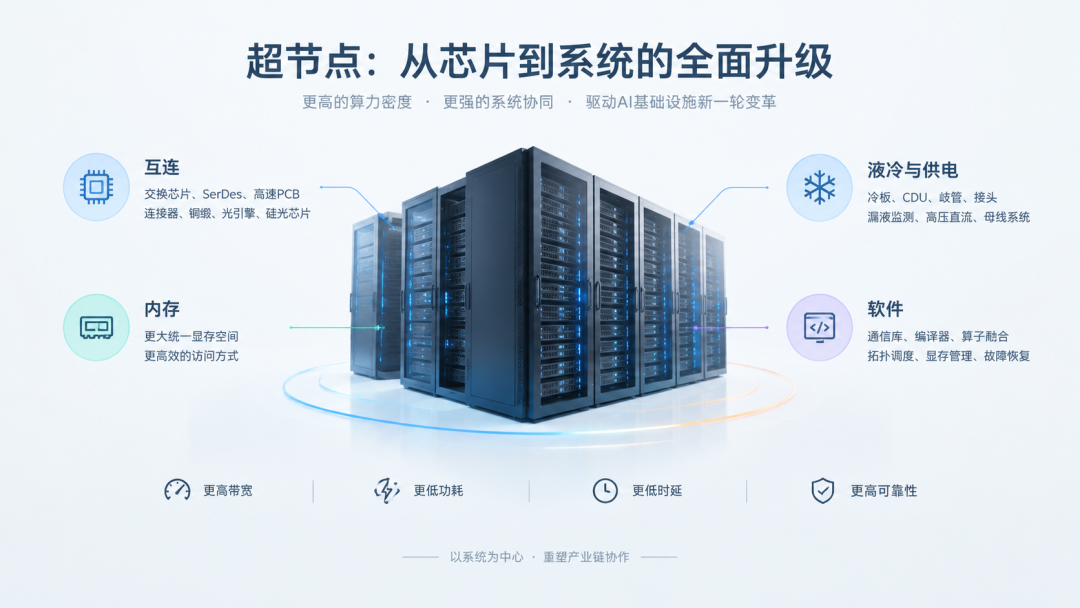
当计算边界从服务器扩大到机柜,上游产业链也随之发生变化。
这些升级不是同时出现的几条独立需求,而是由芯片密度提高依次传导出来的一整套系统要求:芯片数量增加,带来更大的通信量;通信规模扩大,推高带宽与互连距离要求;功率和热量随之上升,供电和冷却必须同步重做;部件和链路增多以后,软件调度与故障恢复又成为系统稳定运行的前提。
首先变化的是互连。
芯片数量增加以后,交换芯片、SerDes高速串并转换器、高速PCB、连接器、铜缆、光引擎和硅光芯片都会直接影响系统性能。互连过去更多承担连接功能,现在开始参与定义一套算力系统能够扩展到多大。
第二个变化来自内存。
大模型需要同时容纳模型权重、激活数据和不断增长的KV Cache。超节点由此需要更大的统一显存空间,以及显存、内存和存储之间更高效的访问方式。HBM高带宽内存的容量、内存带宽、统一编址和缓存分层,都会影响模型能否装得下、跑得快。
第三个变化发生在液冷和供电。
芯片密度提高以后,一个机柜需要承载更高的功率和热量。冷板、CDU冷量分配单元、歧管、快速接头、漏液监测、高压直流供电和母线系统,开始与计算架构同步设计。
数据中心交付的对象也在改变。客户购买的不再只是一批服务器,还包括与之匹配的网络、供电、冷却和运维系统。
第四个变化来自软件。
几百颗芯片被连接起来,并不代表它们自然就能高效工作。通信库、编译器、算子融合、拓扑感知调度、显存管理和故障恢复,决定了硬件能够释放多少性能。
超节点越大,软件调度和系统可靠性的重要性越高。
任何一块芯片、一条链路或者一个电源模块出现故障,都可能影响长时间运行的训练和推理任务。系统需要及时隔离故障、重新分配任务,并让模型从中断位置继续运行。
超节点由此改变了产业链的协作方式:各个部件不能再分别追求自己的最高参数,而要围绕整套系统的带宽、功耗、时延和可靠性共同设计。
04 价值开始从“峰值算力”走向“有效算力
过去,算力产品最容易被比较的是芯片参数和峰值FLOPS。
进入Agent时代以后,在推理服务中,客户越来越直接地以Token产出衡量算力效率。系统每秒能够稳定生成多少Token,每百万Token需要多少成本,一项持续数小时的任务能否顺利完成,开始成为更直接的衡量指标。
所谓有效算力,不只是系统理论上拥有多少FLOPS,而是在真实模型负载下,能够以多低的成本、多高的速度、多稳定地持续生产Token。
单卡性能仍然是算力系统的地基,系统效率决定这些芯片最终能够形成多少产能。
这也会改变产业链中的价值分配。
交换芯片、光引擎、高速连接、统一内存、液冷供电和系统软件,将获得更高的技术权重。传统服务器厂商的能力边界,也会从整机集成进一步走向系统架构、软件优化和数据中心协同。
云厂商和全栈基础设施企业则有机会获得更强的架构定义权。它们既了解模型的计算特征,也能够从芯片、网络一直优化到Token服务,把真实负载反向写入下一代硬件设计。
超节点集体升级,意味着AI算力正在进入系统级竞争阶段。
当单颗芯片的提升越来越难以独立满足模型需求,产业开始通过互连、内存和系统协同继续扩大计算能力。
下一阶段的算力竞争,争夺的正是系统定义权。谁能在真实负载下,把芯片、互连、内存、供电、冷却和软件组织成稳定的Token产能,谁就更有可能定义下一代算力基础设施。

