

文|Alpha说
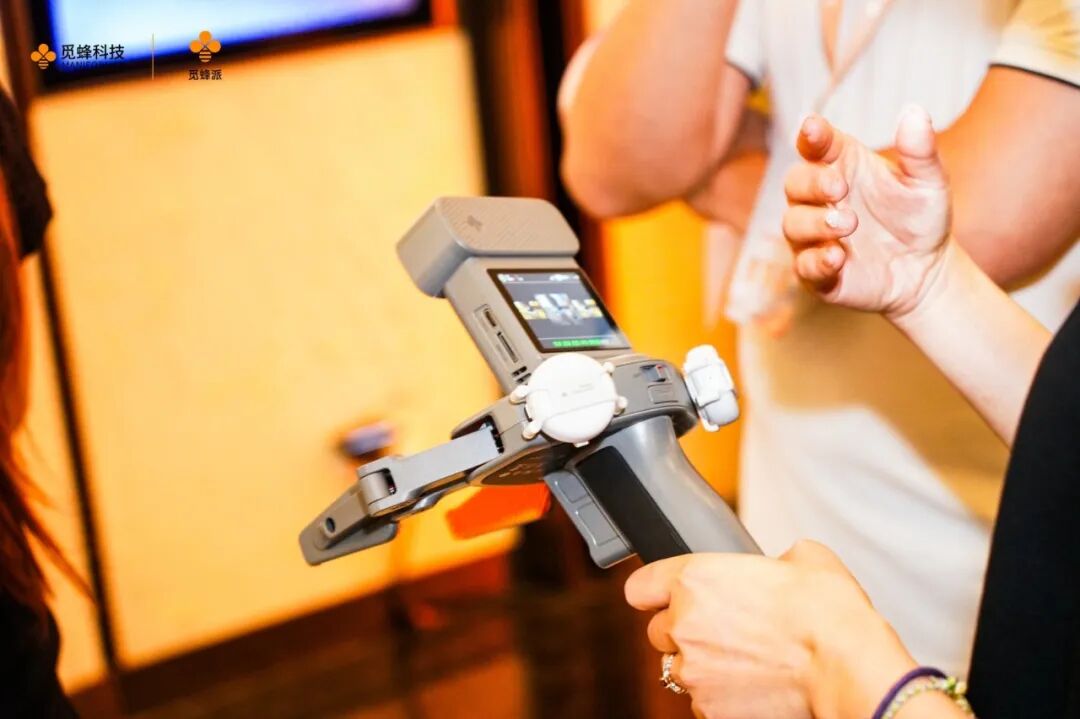
9月23日的发布会现场,一位苏式糕点非遗传承人戴上MEgo设备,开始制作一枚玫瑰豆沙月饼。
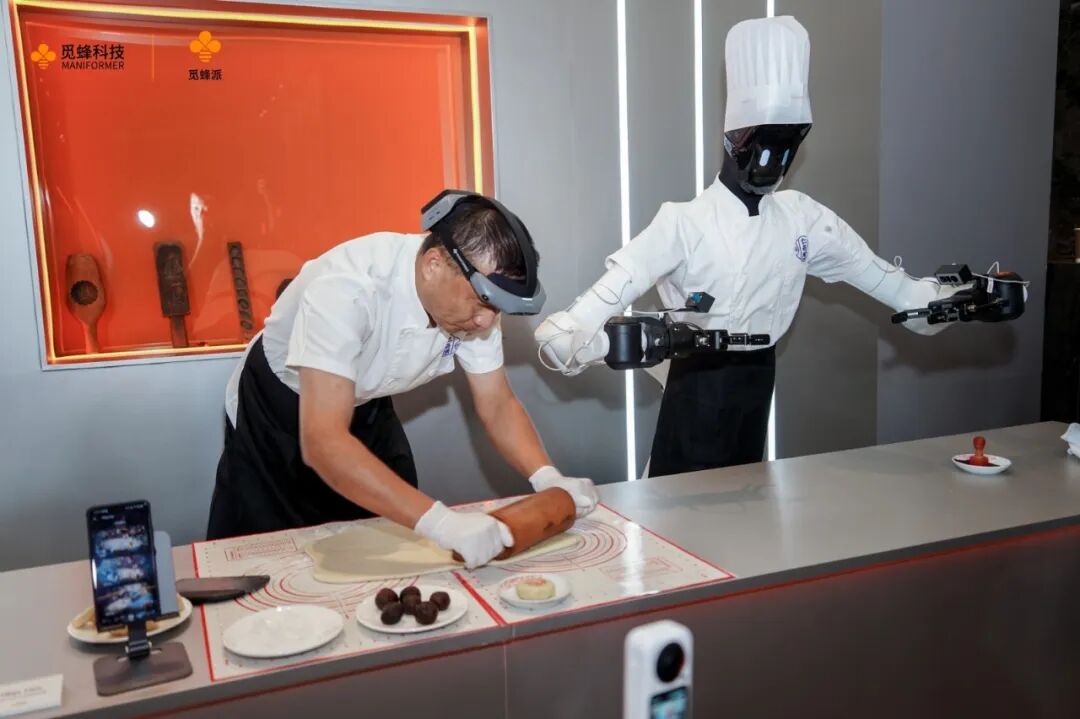
擀皮、包馅、收口、压模。过去,这些动作依靠师傅带徒弟传承;在现场,它们被设备记录下来。随后,发布会继续演示了任务领取、数据采集、平台验收与收益结算的完整流程。现场展示的钱包余额来自此前已经通过验收的数据。
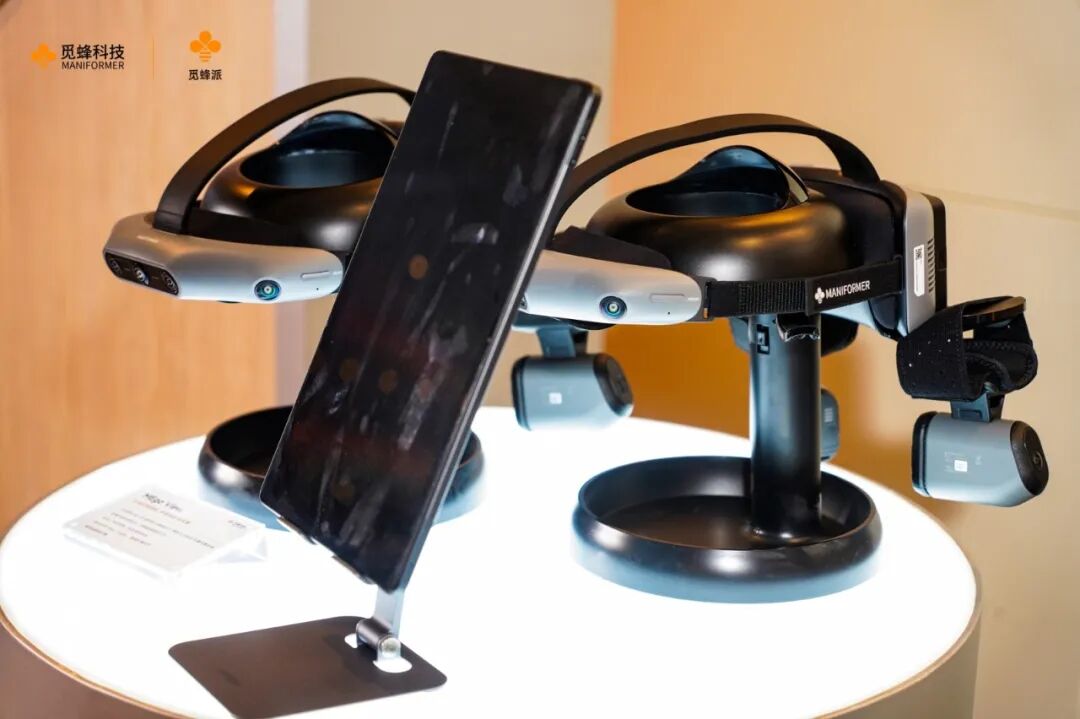
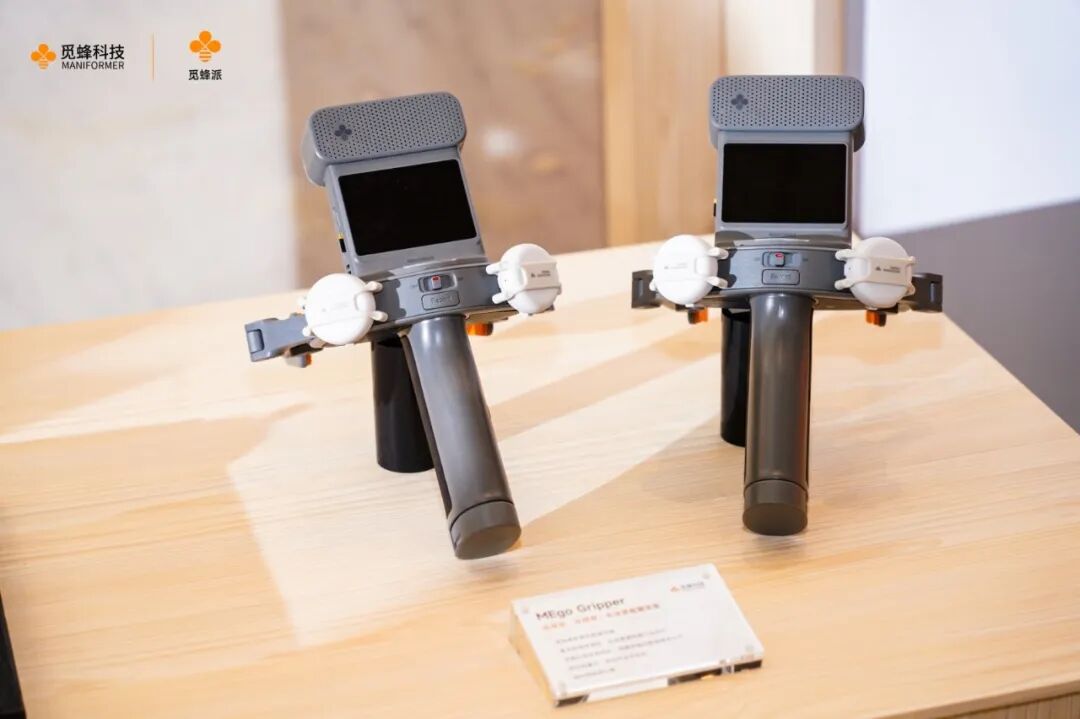
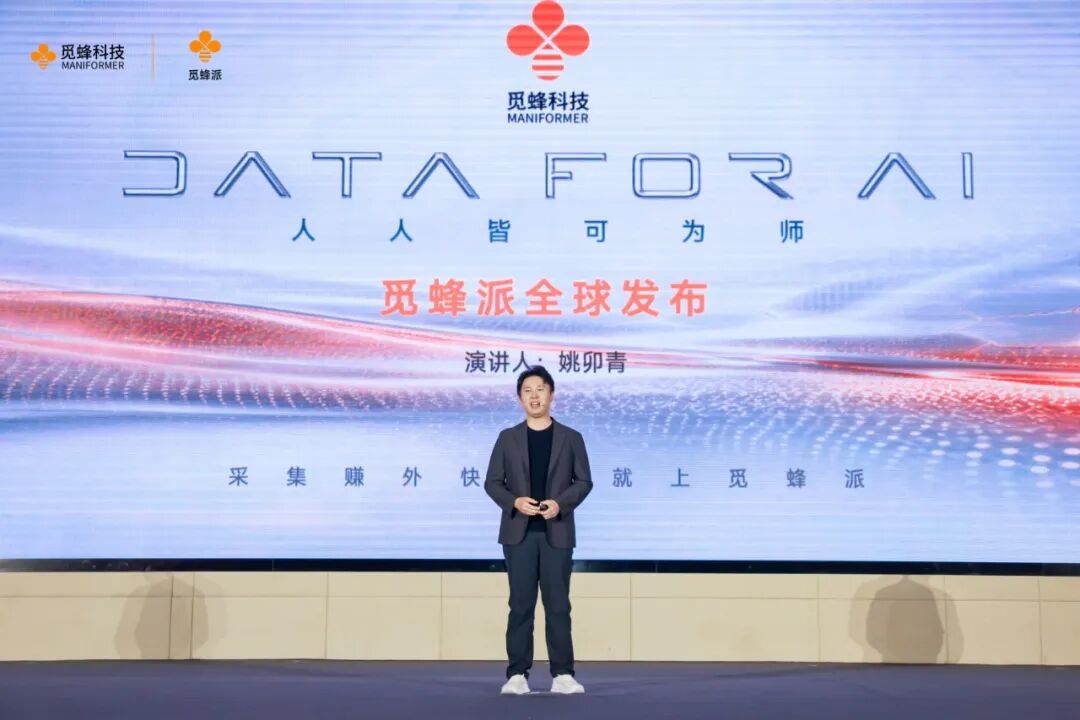
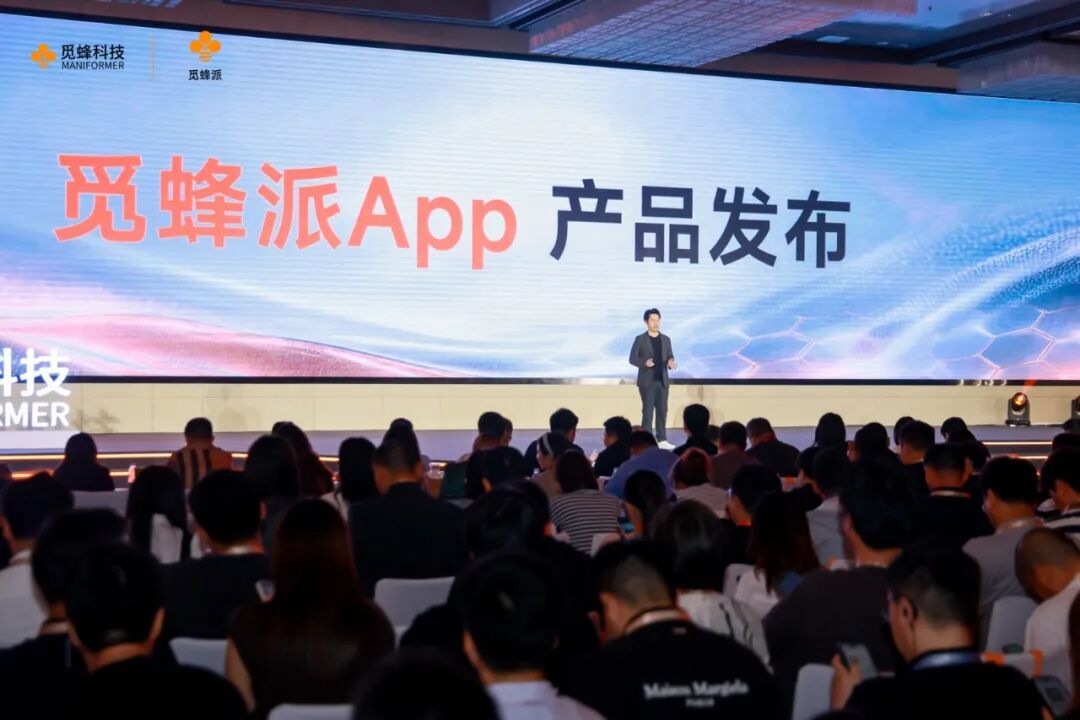
同一天,觅蜂科技正式发布物理AI数据众包服务平台“觅蜂派”。用户可以在平台领取数据采集任务,申领MEgo设备,在工厂、商店、酒店、家庭等真实场景中完成指定操作,并按照审核后的有效数据时长获得报酬。
觅蜂科技董事长兼CEO姚卯青将其概括为一句话:“Data for AI,人人皆可为师。”
但觅蜂派此次发布真正值得关注的,并不只是普通人多了一种获取收入的方式。
在已经拥有百万小时数据积累后,觅蜂为什么还要从集中式采集走向全民众包?
物理AI数据竞争正在发生的一次变化:当常见动作的数据逐渐增多,行业下一步需要解决的,是如何进入大量分散的长尾场景,找到那些尚未被记录的专业技能。
01 百万小时之后,数据需求还在继续增长
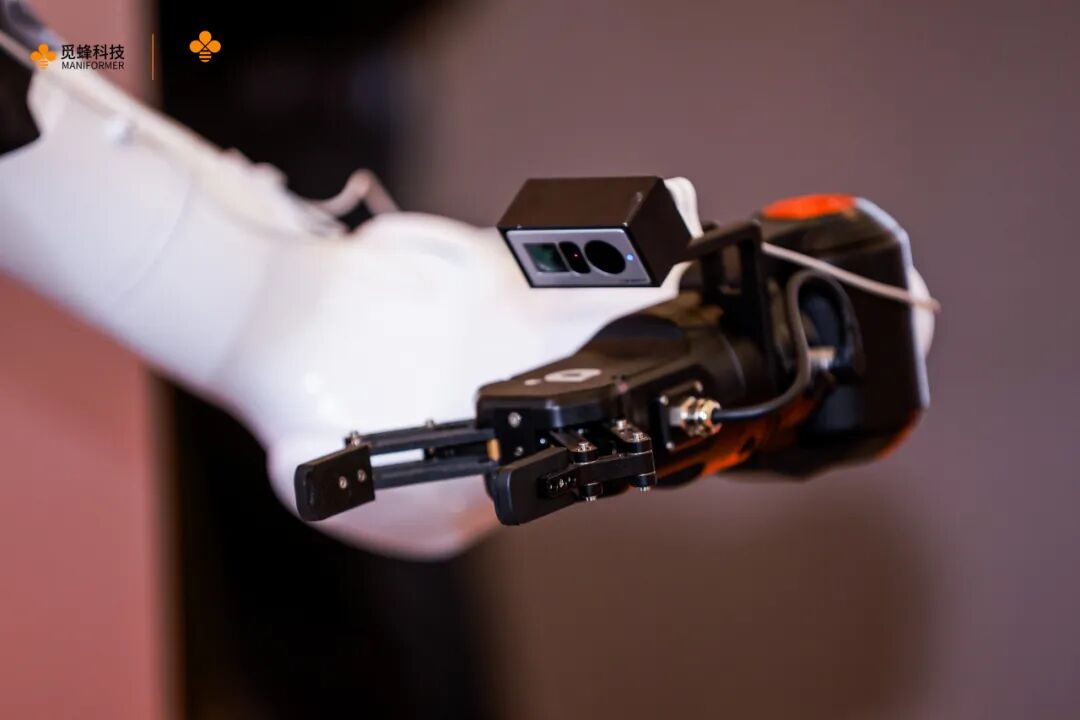
大模型可以从互联网上获得大量数字世界的知识,物理世界中的操作经验却长期缺少系统记录。
怎样维修一根水管,怎样给汽车做保养,理发师如何控制剪刀的角度,护工如何把一勺饭平稳地送到老人嘴边——这些经验存在于不同职业的日常工作中,也存在于人的手、眼和身体之间长期形成的配合里。
简单的视频还不够。高质量物理AI数据还需要包含音频、触觉、力觉和空间轨迹等多模态信息,并对内容、动作和场景进行语义描述。
截至8月31日,公司第20,000套MEgo无本体数据采集设备已经下线,累计生产超过100万小时无本体数据。但当模型训练所需的数据量继续增加,仅依靠企业集中组织采集,已经难以高效进入大量分散的专业场景。
姚卯青在接受Alpha说采访时表示,对于当前市场需求而言,百万小时数据已经无法满足所有需求,不少公司的单个模型数据需求已达到1500万小时级。这也是觅蜂科技开始寻找下一条数据获取增长曲线的原因。
数据量仍在增长,需求本身也在变化。
一些家庭环境中的常见操作已经被大量采集。模型继续向制造、商业服务、康养和其他行业深入时,需要学习的开始变成更加细分、更加专业的技能。
姚卯青举了几个例子:修水管、修车、理发和美甲。它们分布在不同城市、不同门店和不同从业者手中,很难被一座数据工厂集中容纳,却可能构成物理AI继续进入真实产业所需要的新数据。
“这些技能需要一个个点亮、一个个解锁。”他说。
02 真正需要突破的,是场景丰富度
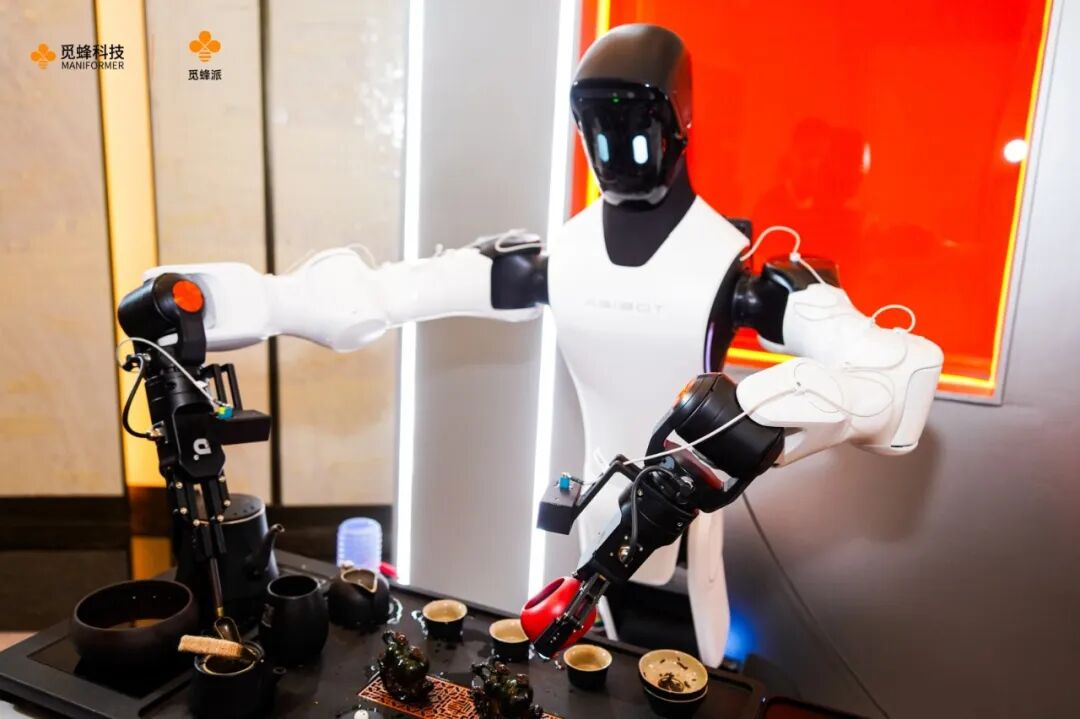
集中式数据采集的优势很明确:设备、人员和流程相对统一,质量也更容易控制。它适合生产一批需求明确、动作标准、可以重复执行的数据。
真实世界的技能却呈现出另一种分布方式。
一家汽车维修店、一间美甲店、一座酒店和一条工厂产线,各自拥有不同的操作环境。即使执行相似任务,工具、物品、空间和动作习惯也可能不同。企业逐一寻找场地、沟通采集、组织人员,能够覆盖的行业和场景始终有限。
众包在这里承担的作用,是把数据采集能力送到这些分散的场景中。
03 众包如何进入分散的真实场景
从觅蜂派公布的流程看,平台把采集需求呈现为具体任务,并提前写明操作步骤、设备要求、验收标准和收益规则;采集者领取设备,在自己能够进入的真实环境中完成任务;数据上传后,再由MEgo Engine完成切片、标注和质量检查。
发布会公布的验收标准包括合规、真实、标准、任务与素材对应,以及同一任务覆盖多个真实点位等维度。平台所做的,是让分散在不同地点、由不同人完成的动作,进入一套相对统一的数据生产流程。
普通人完成的是这条生产链的起点。原始采集内容经过清洗、切分、语义标注、动作解析和质量分级后,才进一步成为可以交付的数据产品。
这也是为什么姚卯青把现阶段最需要突破的能力指向“场景丰富度”。
“到现在这个阶段,场景丰富度肯定是最关键的,因为质量是一个基础。”他表示,经过此前百万小时数据的积累,觅蜂科技已经持续打磨数据质量体系。无论数据来自原有的集中式采集,还是新的分布式众包,都会进入MEgo Engine进行标准化处理。
众包由此补充的,并非简单的采集人数,而是一张进入不同行业和真实场景的数据供给网络。
04 AI需要的“老师”,藏在每一个行业里
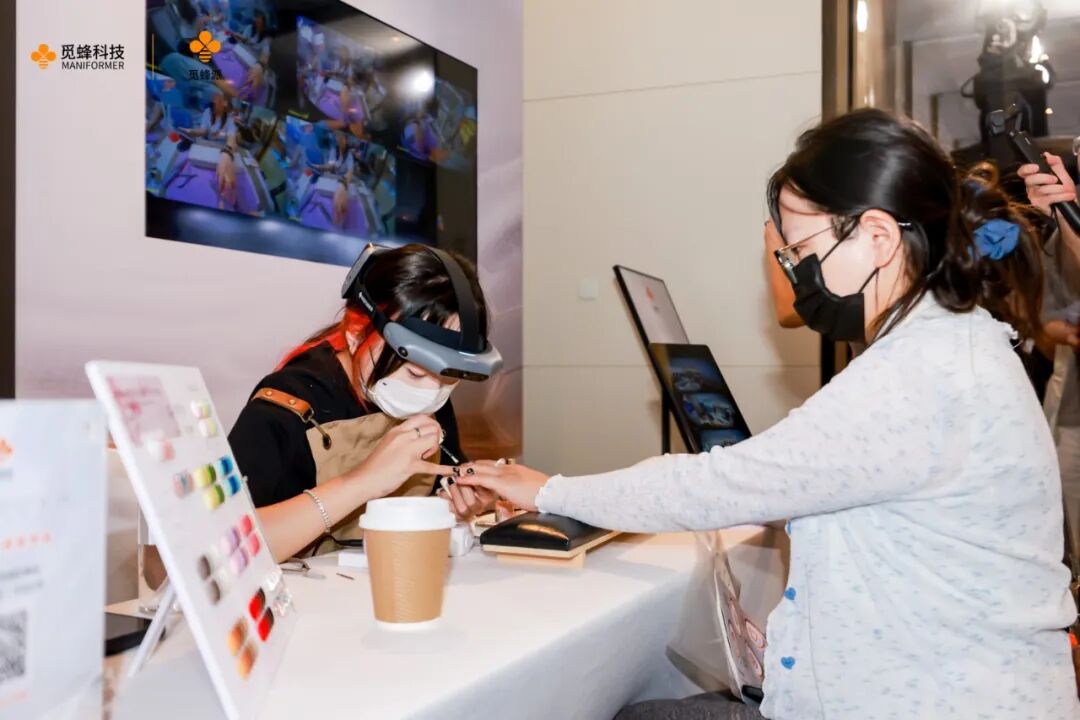
姚卯青在采访中把众包数据与自媒体作了类比。
电视时代,内容主要由少数机构生产;进入自媒体时代,每个人记录自己的生活,内容的数量和丰富度都被进一步打开。物理AI数据也可能经历类似的变化:集中式采集建立基础产能,分布式采集把更多真实的人、职业和技能带入数据网络。
这个类比更重要的一层,是数据生产主体的变化。
维修工人、理发师和非遗手艺人掌握着各自行业中的真实操作经验。这些经验经过设备记录和标准化处理后,可以转化为物理AI训练所需的数据。
物理AI数据的稀缺性,也会随之发生变化。
当采集设备逐渐普及,常见动作越来越多,价值会继续向更深处移动:哪些场景尚未被覆盖,哪些技能值得优先采集,怎样把模型需求翻译成普通人能够完成的任务,以及如何把分散的动作稳定转化为可用数据。这意味着,未来的数据竞争很难只用设备数量或者累计时长来衡量。谁能持续进入更多真实行业,组织更多拥有专业技能的人,并把他们的经验纳入统一的数据生产和治理体系,谁就更有可能掌握物理AI的数据入口。
觅蜂派的发布,让觅蜂科技从采集设备与数据治理进一步走向数据供给网络。发布会披露,在一个月内测期间,平台注册用户达到2万人,采集提交总量为1.3万份。平台目前覆盖22类场景、5000余种任务类型,相关数字仍在增长。
这些数字呈现的是网络刚刚启动时的规模。更值得关注的是,平台能否不断找到新的专业技能,并把它们转化为稳定、可复用的数据供给。
当AI开始走进更复杂的产业现场,它需要寻找的老师,正是那些在各行各业中,把一件事做过成千上万遍的人。

