文|半导体产业纵横
一台放在办公桌上、比机顶盒大不了多少的机器,塞着上百 GB 统一内存,断网也能跑千亿参数大模型。不用机房,不用机柜,插电即用,数据不出房门。这就是AI Box,一台搬上办公桌的数据中心。
AI Box赛道中苹果、英伟达、AMD、微软、英特尔悉数到场。但这种形态并不新鲜,为何2026年“连上显示器就是台电脑”的小盒子成了必争之地?
大模型有两种用法:调云端,或者在本地跑。
云端意味着AI能力无上限,模型不用自己管,最强的能力随时可用。但账也很清楚:订阅制里,ChatGPT Pro、Claude Max 都是 200 美元/月封顶;封顶之外按量计费,9 月 3 日刚发布的 GPT-6 Astra,输出价格是每百万token 50 美元。对跑智能体的重度用户,一次长任务输出数万 token,一个月烧掉几百到上千美元是常态。
业内人士表示,过去两年企业上 AI,绝大多数卡在“从概念到落地”的摸索期:场景要试、流程要换、提示词要调。这个阶段每一分钟都在花 token 的钱,而老板往往只给得出方向,给不出具体要求。“烧了很多钱,出什么结果呢?不知道。”
本地部署的逻辑因此成立:主流模型大多开源免费(DeepSeek、Qwen 系列均为宽松协议开源),硬件一次性购入,之后没有 token 账单,数据不出机房。预研、验证、反复试错,成本是固定的。
AI Box因此而生。
01 什么样的Box才能叫AI Box?
AI本地部署有一道硬门槛:模型得先“装得下”,内存就是AI Box的入场券。
跑大模型的前提,是权重全部装进内存或显存。DeepSeek-R1 满血版 6710 亿参数,全精度(FP16)需要约 1.3TB 显存,FP8 量化约 0.7—0.8TB,即使 4-bit 量化也要 400—480GB8。作为对照,一张 RTX 5090 是 32GB 显存9,一台高配笔记本是 24—32GB 统一内存——只能塞下 70 亿参数级别的小模型。
这就是桌面 AI 设备最大的技术命题:在一台放得进桌子的机器里,塞进尽可能大的统一内存,喂给模型尽可能高的带宽,再把功耗压进办公室插座能承受的范围。
容量决定能跑多大的模型,带宽决定多少人能同时用、出字有多快,功耗决定它能不能放在办公室而不是机房。在这三个维度上,最戏剧化的事情是:准备最充分的那家公司,本来不是为 AI 设计的。
2020 年,苹果把 Mac 迁到自研 M 系列芯片,做了一个当时看相当激进的决定:CPU、GPU、神经引擎共享同一块内存,内存即显存。这个叫统一内存(UMA)的架构,初衷是砍掉数据在芯片间搬运的开销、压低功耗。
五年后大模型时代降临,这套架构刚好踩中了所有需求点。
今天的 Mac Studio,M3 Ultra 版本最高可选 512GB 统一内存、内存带宽 819GB/s,整机最大持续功耗 480W10;9 月 22 日发售的 M5 Ultra 款,带宽进一步拉到 1.2TB/s,国行 46999 元起。苹果官方口径,这台机器可以跑 6000 亿参数以上的模型。 据报道,过去几个月,OpenAI 采购了数万台 Mac mini 和 Mac Studio用于强化学习和Agent的开发,需求旺到多次催促苹果发货。库克在 7 月的财报电话会上承认,“越来越多客户把 Mac mini 用作运行智能体的强大平台、部署 Mac Studio 集群在本地运行前沿模型”,并表示当季 Mac 一直面临供应限制。
02 英伟达:不卖机器,卖“同款架构”
如果说苹果是“无心插柳”,英伟达则是看到了市场需求后的“降维打击”。
DGX Spark 用的是 GB10 Grace Blackwell 超级芯片,128GB 统一内存、273GB/s 带宽、FP4 精度下 1 PFLOPS 算力,整机功耗 240W,官方标称单机可推理 2000 亿参数模型、两台互联跑 4050 亿。美国官网售价 4699 美元,国行首发价约 3 万元,内存涨价后已逼近 4 万。
单看纸面参数,它对 Mac Studio 毫无优势。但 DGX Spark 跑的是 DGX OS(Ubuntu),软件栈和数据中心里的万卡集群同源,CUDA 生态、企业级支持,开发者在桌上调好的东西,可以无缝搬到云上。
围绕英伟达DGX Spark,宏碁、华硕、戴尔、技嘉、惠普、联想、微星七家 OEM 同时推出同芯片整机,微星的版本低到 2999 美元,联想 ThinkStation PGX 去年 7 月已经进入中国政企采购目录。相对于苹果,英伟达给AI Box更加清晰的市场定位与销售野心。
如果说 Spark 是给开发者的入门机,DGX Station 就是给小团队的桌边工作站:GB300 芯片、748GB 一致性内存(252GB HBM3e 加 496GB LPDDR5X)、FP4 20 PFLOPS、整机 1600W,官方宣称能跑万亿参数模。虽然功耗已经摸到普通办公室电路的上限,但仍然比机房服务器低一个数量级。
今年 6 月 Build 大会,微软发布 Surface RTX Spark Dev Box:和 DGX Spark 同款 GB10 芯片、128GB 统一内存、1 PFLOPS,热设计功耗压到 100W,预装 Windows 11 Pro 开发者版,标称本地可跑 1200 亿参数模型、百万 token 上下文,下半年在美国发售,媒体估价 3000—3500 美元。它的入场意义大于产品意义:Windows 生态需要一个官方答案,告诉开发者本地 AI 不必非买 Mac。
03 X86阵营:展示推理时代的性价比
AMD 的Ryzen AI Max+ 395(代号 Strix Halo)把 128GB 统一内存、256GB/s 带宽做进了 55—120W 的功耗墙,NPU 50 TOPS、平台总算力约 126 TOPS。今年三季度,换代的 Ryzen AI Max 400(Gorgon Halo)会把统一内存上限拉到 192GB,官方称可跑 3000 亿参数模型。
X86的底牌是兼容,Windows、Linux 直接装,企业已有的运维体系全部复用。性能不是最强,但不用换生态,就是采购决策里最大的权重。
英特尔推出了 Panther Lake(Core Ultra 300 系),NPU 算力 50 TOPS,塞进每一台笔记本和迷你主机;最接近盒子形态的 NUC 16 Pro,内存上限 96GB,定位是 Copilot+ 迷你 PC。值得注意的是,英特尔的AI Box不只是放在桌面上的盒子,英特尔还把AI Box放到了智能汽车上,让过去算力不足的汽车拥有算力加成。可以看出,英特尔将AI Box的目标定位到了更具体的B端场景中。
04 AI Box,到底谁在买?
盒子卖出去之后,到底干出了什么?
在高职教育场景中,学校把备课、批改、实训答疑、教案沉淀分别做成教师、学生、管理三组智能体,装在盒子里本地化运行。试点后的数据是:教师周均备课时间从 9.2 小时降到 5.1 小时,每班批改时间从 2 小时压到 0.4 小时,实训错误率从 22% 降到 14.3%,优秀教案复用率从不到 10% 提到 67%。
另一个是律所场景,卷宗不能出所,正是盒子的主场:类案检索压缩到 40 秒以内,司法文书自动生成覆盖率 80% 以上,利益冲突审查准确率 95% 以上。
这些场景的选择逻辑很清晰:重复性资料处理 + 数据安全敏感 + 结果可被人工复核。而AI Box的优势也十分明显,传统本地服务器方案要机房改造、周期三到六个月,公有云 API 即时开通但数据有出域风险,而盒子桌面即插即用、物理隔离,部署时间以小时计。
从卖算力到卖效率,这个转变本身说明:市场已经过了“为参数买单”的阶段,开始为结果买单。
05 写在最后
AI Box有多大潜力算的是一笔经济账。
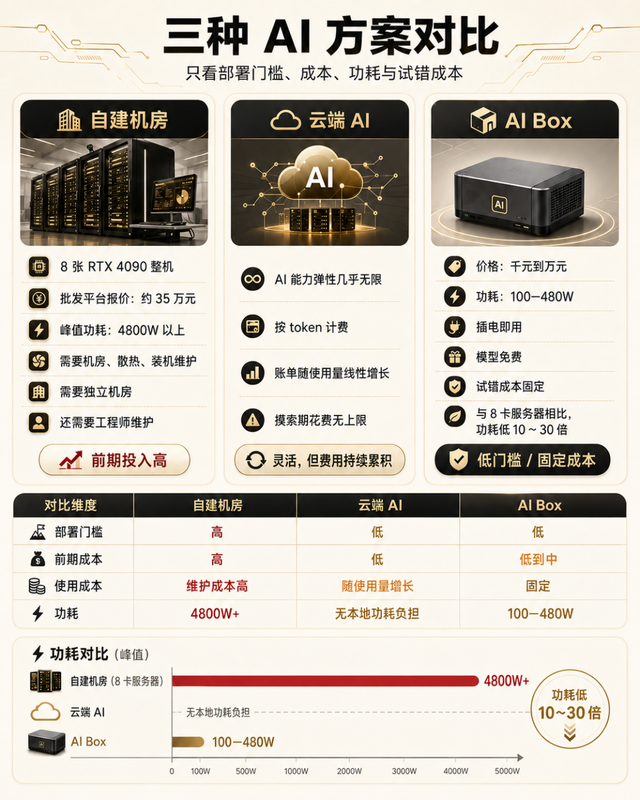
自建机房要8 张 RTX 4090 的整机,批发平台上报价 35 万元上下,整机峰值功耗 4800W 以上,要机房、要散热、要工程师装机维护,一定需要一个独立机房。
云端AI能力无限,但 token 账单随使用量线性增长,摸索期花费无上限。
AI Box 从千元到万元,功耗 100—480W,插电即用,模型免费,试错成本固定。与 8 卡服务器相比,功耗相差 10 到 30 倍。
摆在行业面前的问题是,ROI 仍然算不清。真正掏钱的采购方,得拿自己的流程重新折算一遍。客服这类能折算成“少多少坐席”的场景好量化,但所谓对流程的优化,效率的提升无法良好。此外,如同自动驾驶推进的权责问题,在实际工作中如果AI 出错,谁来检查,谁来负责,也没有答案。
现实情况是,当前成熟场景只有两个:写代码和办公,其余场景大多还在摸索。而硬件只是门票:数据治理、微调、迭代以三到六个月为周期,模型一换,上层应用大概率要跟着返工。还有一个思考是,一般情况下,盒子不能升级,扩容只能再买一台机器。在 DRAM 成本高企的情况下卖盒子似乎成了消化高价存储的一种方案。对市场来说,他们更需要看到AI Box到底能做什么。
AI Box 不是来取代云的。需要最强模型、弹性算力、零维护的任务,云端依旧是最优解。盒子承接的是另一类需求:反复试错的预研、不愿上云的数据、十来人小团队的固定算力、算得清电费和折旧的小本生意。
AI Box的出现是把硬件做小,在支付固定成本后,实现算力自由。归根结底,产品的未来是算力如何落地,如何带来真正的价值。